Sự cố mất điện kỹ thuật số: Vì sao sự gián đoạn mới nhất của Microsoft báo hiệu một cuộc khủng hoảng mang tính hệ thống
A cascading failure across Microsoft’s 365 ecosystem has paralyzed global business, forcing a re-evaluation of the fragility inherent in our hyper-connected digital infrastructure.
Sự cố lỗi dây chuyền trong hệ sinh thái Microsoft 365 đã làm tê liệt hoạt động kinh doanh toàn cầu, buộc thế giới phải nhìn nhận lại mức độ mong manh tiềm ẩn trong hạ tầng kỹ thuật số siêu kết nối của chúng ta.
Une défaillance en cascade au sein de l'écosystème Microsoft 365 a paralysé les activités mondiales, forçant une réévaluation de la fragilité inhérente à notre infrastructure numérique hyperconnectée.
Un fallo en cascada en todo el ecosistema 365 de Microsoft ha paralizado la actividad empresarial global, obligando a replantearse la fragilidad inherente a nuestra infraestructura digital hiperconectada.
微软 365 生态系统近期发生的连锁故障导致全球商业活动陷入瘫痪,迫使各界重新审视高度互联的数字基础设施中潜藏的脆弱性。此次事件不仅是一次技术失误,更暴露了全球经济对单一超大规模云服务商过度依赖的深层隐患。
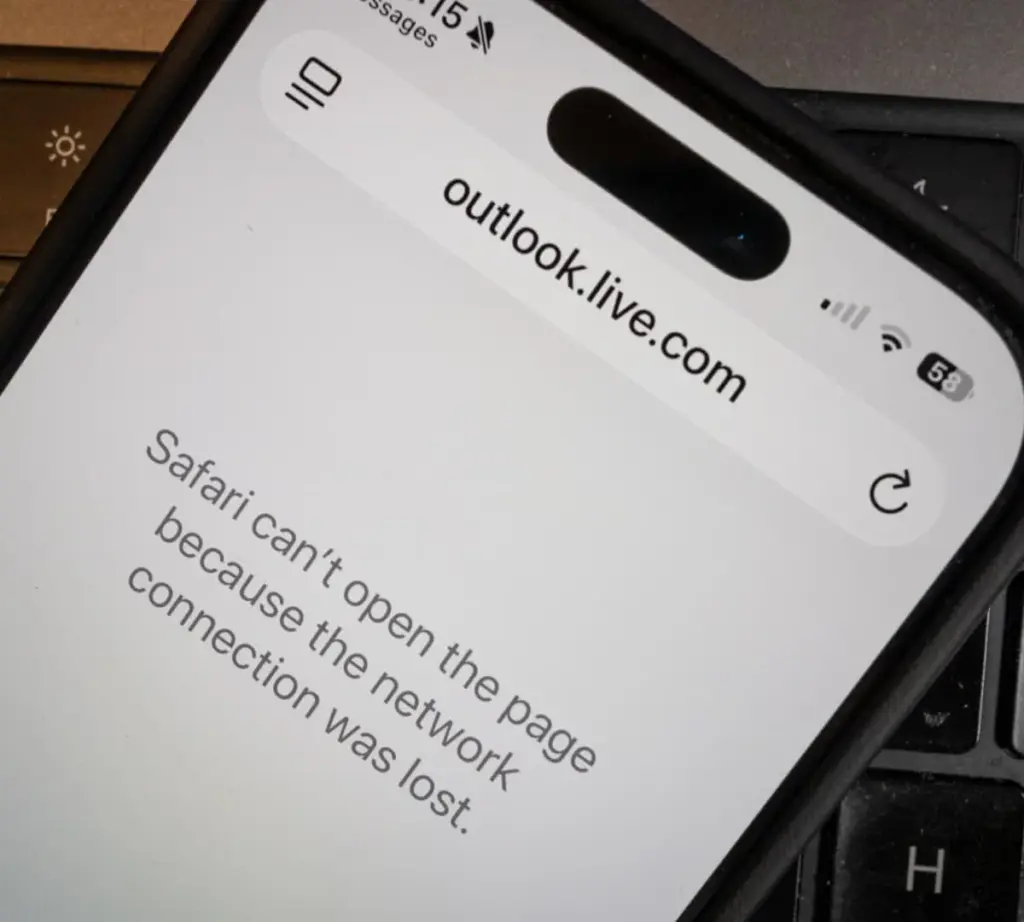
- Microsoft 365 services, including Outlook and Teams, suffered a multi-day global outage triggered by server health check failures.
- The incident forced major corporate delays, including the rescheduling of earnings reports for firms like Workhorse Group.
- Government officials have drawn parallels to the 2024 CrowdStrike incident, highlighting the risks of centralized software updates.
- Microsoft is currently implementing a new server health verification method to stabilize capacity while extending email delivery windows.
- Các dịch vụ của Microsoft 365, bao gồm Outlook và Teams, đã trải qua sự cố ngừng hoạt động toàn cầu kéo dài nhiều ngày do lỗi kiểm tra tình trạng máy chủ.
- Sự cố buộc các doanh nghiệp lớn phải hoãn lịch trình, bao gồm việc dời lại báo cáo lợi nhuận của các công ty như Workhorse Group.
- Các quan chức chính phủ đã vẽ ra sự tương đồng với sự cố CrowdStrike năm 2024, nhấn mạnh rủi ro từ các bản cập nhật phần mềm tập trung hóa.
- Microsoft hiện đang triển khai phương pháp xác minh tình trạng máy chủ mới để ổn định dung lượng trong khi vẫn kéo dài thời gian gửi email.
- Les services de Microsoft 365, incluant Outlook et Teams, ont subi une panne mondiale de plusieurs jours déclenchée par des défaillances de contrôle de l'état des serveurs.
- L'incident a provoqué d'importants retards pour les entreprises, allant jusqu'au report de publications de résultats financiers pour des sociétés comme Workhorse Group.
- Des responsables gouvernementaux ont dressé des parallèles avec la panne CrowdStrike de 2024, mettant en lumière les risques liés aux mises à jour logicielles centralisées.
- Microsoft met actuellement en place une nouvelle méthode de vérification de l'état des serveurs pour stabiliser la capacité tout en étendant les fenêtres de distribution des e-mails.
- Los servicios de Microsoft 365, incluidos Outlook y Teams, sufrieron un apagón global de varios días provocado por fallos en las comprobaciones del estado de los servidores.
- El incidente obligó a retrasar importantes compromisos corporativos, como la presentación de resultados de firmas como Workhorse Group.
- Responsables gubernamentales han trazado paralelismos con el incidente de CrowdStrike de 2024, destacando los riesgos de las actualizaciones de software centralizadas.
- Microsoft está implementando un nuevo método de verificación del estado de los servidores para estabilizar la capacidad y, al mismo tiempo, ampliar los plazos de entrega de los correos electrónicos.
- 微软 365 服务(包括 Outlook 和 Teams)因服务器健康检查组件故障,遭遇了持续数日的全球性宕机。
- 此次事故导致多家大型企业被迫调整运营节奏,例如 Workhorse Group 等公司不得不推迟财报发布。
- 政府官员将此次事件与 2024 年的 CrowdStrike 故障相提并论,凸显了集中式软件更新带来的系统性风险。
- 微软目前正部署一种新的服务器健康验证机制以稳定负载,并延长了电子邮件的投递窗口期以应对积压。
The modern global economy runs on a thin, invisible layer of software that we rarely notice until it vanishes. This week, that layer fractured. Starting Thursday afternoon, a widespread failure within Microsoft’s infrastructure effectively silenced the digital heartbeat of millions of enterprises, government agencies, and individual users. From the trading floors of London to the corporate offices of the Asia-Pacific region, the sudden unavailability of Outlook, Teams, and SharePoint served as a stark reminder that our reliance on a handful of hyperscale cloud providers has created a single point of failure that is as fragile as it is essential.
While Microsoft engineers scrambled to diagnose the root cause—initially pointing to a traffic surge and a malfunctioning server health-check component—the fallout was immediate and indiscriminate. The outage did not merely disrupt internal communications; it halted the machinery of commerce. As the sun rose over Europe on Friday, the silence of email servers became a deafening indicator of a systemic vulnerability. For a world that has migrated its entire operational stack into the cloud, the inability to access one’s digital workspace is no longer a minor inconvenience; it is a total cessation of business continuity.
The Anatomy of a Cloud Collapse
The technical genesis of the outage appears to be a failure in the automated systems responsible for monitoring server health. According to Microsoft, a component tasked with verifying the status of servers began to malfunction, triggering a cascading effect where healthy servers were incorrectly flagged as unresponsive. This created a "bottleneck of recovery," where the infrastructure struggled to handle the load as systems were taken offline for manual intervention. The irony is palpable: the very tools designed to ensure high availability and automated resilience were the catalysts for the collapse.
This incident is particularly sensitive given the recent history of large-scale IT disruptions. When Australian Home Affairs Minister Tony Burke drew comparisons to the 2024 CrowdStrike incident, he touched upon a growing anxiety in the C-suite: the fear of "update-induced" systemic failure. While Microsoft has been quick to clarify that this was not a malicious cyberattack, the operational impact mirrors the chaos of a security breach. When a central nervous system like Microsoft 365 goes dark, the secondary effects on dependent services—ranging from calendar integrations to third-party CRM platforms—create a ripple effect that is difficult to contain.
Economic Ripples and Corporate Disruption
The economic cost of such an outage is difficult to quantify in real-time, but the signals are already appearing in the market. Shares of Microsoft dipped 2.6% in premarket trading, reflecting investor unease regarding the reliability of the company’s cloud-first strategy. More tangibly, the disruption forced a recalibration of corporate timelines. The Swiss luxury giant Richemont saw its earnings release delayed, and the electric truck maker Workhorse Group was forced to push its third-quarter results to next week. These are not merely administrative delays; they are disruptions to the transparency and timing that global markets demand.
Beyond the boardroom, the impact on logistics and service sectors was profound. Air India, for instance, had to resort to manual rerouting of emails to maintain customer service, a stark reminder of how quickly "digital-first" organizations revert to analog workarounds when the cloud fails. The incident highlights a critical flaw in the modern business model: the assumption of "five-nines" availability (99.999% uptime). When that assumption is violated, businesses find themselves without a contingency plan, having offloaded their core infrastructure to a provider that, while powerful, is not infallible.
The Fragility of Hyper-Scale Centralization
We are currently witnessing a period of intense consolidation in the tech sector, where AI-integrated tools like Microsoft Copilot are being woven into the very fabric of daily productivity. With over 100 million monthly active users, Copilot is no longer an experimental feature; it is a foundational layer of the enterprise. When this layer fails, the productivity loss is not just linear—it is exponential. The reliance on a singular, massive ecosystem means that a bug in a server health-check component can effectively "pause" the global economy.
This centralization is a double-edged sword. On one hand, it provides unparalleled efficiency, security, and integration. On the other, it creates a "too big to fail" scenario that regulators are increasingly scrutinizing. As companies continue to migrate their legacy systems to the cloud, the pressure on providers like Microsoft, Amazon Web Services, and Google to maintain absolute stability grows. This week’s events will undoubtedly trigger a wave of "cloud diversification" discussions, as CTOs and CIOs begin to question whether a single-vendor strategy is a risk they can afford to maintain in an increasingly volatile digital landscape.
Looking Ahead: The Path to Resilience
As Microsoft moves toward stabilization, the focus shifts from immediate recovery to long-term accountability. The company’s decision to extend the timeout window for email delivery by 48 hours is a necessary "band-aid" to preserve data integrity, but it does not address the underlying architectural issues. The engineering challenge now is to build "fail-safes" that prevent automated health checks from triggering a self-inflicted denial-of-service attack. The reliance on automated recovery systems, while efficient, requires a human-in-the-loop oversight that was clearly lacking during this incident.
For the broader tech industry, the lesson is clear: resilience is not just about having redundant servers; it is about having redundant *processes*. As we watch the recovery progress, the global business community will be looking for more than just a "fix." They will be looking for a fundamental change in how these giants manage updates and infrastructure health. In an era where digital connectivity is the oxygen of the global economy, the industry can no longer afford to hold its breath every time a server component fails. The era of blind trust in cloud infrastructure is over; the era of rigorous, transparent, and diversified digital resilience has begun.
Nền kinh tế toàn cầu hiện đại vận hành dựa trên một lớp phần mềm mỏng manh, vô hình mà chúng ta hiếm khi để ý cho đến khi nó biến mất. Tuần này, lớp đó đã rạn nứt. Bắt đầu từ chiều thứ Năm, một sự cố diện rộng trong hạ tầng của Microsoft đã thực sự làmâm thầm hóa nhịp đập kỹ thuật số của hàng triệu doanh nghiệp, cơ quan chính phủ và người dùng cá nhân. Từ các sàn giao dịch ở Luân Đôn đến các văn phòng công ty tại khu vực Châu Á - Thái Bình Dương, việc đột ngột không thể truy cập Outlook, Teams và SharePoint là lời nhắc nhở nhức nhối rằng sự phụ thuộc của chúng ta vào một nhúm nhà cung cấp điện toán đám mây quy mô lớn (hyperscale cloud providers) đã tạo ra một điểm nghẽn duy nhất vừa mong manh lại vừa thiết yếu.
Trong khi các kỹ sư Microsoft vội vã chẩn đoán nguyên nhân gốc rễ—ban đầu cho là do lưu lượng truy cập tăng vọt và một thành phần kiểm tra tình trạng máy chủ bị lỗi—thì hậu quả để lại là tức thời và không loại trừ một ai. Sự cố không chỉ làm gián đoạn giao tiếp nội bộ; nó làm ngưng trệ cỗ máy thương mại. Khi mặt trời mọc ở châu Âu vào ngày thứ Sáu, sự im lặng của các máy chủ email đã trở thành một chỉ báo chói tai về tính dễ bị tổn thương mang tính hệ thống. Đối với một thế giới đã di chuyển toàn bộ cấu trúc vận hành của mình lên đám mây, việc không thể truy cập không gian làm việc kỹ thuật số không còn là một sự bất tiện nhỏ; đó là sự chấm dứt hoàn toàn tính liên tục trong kinh doanh.
Giải phẫu một cuộc sụp đổ điện toán đám mây
Nguồn gốc kỹ thuật của sự cố dường như bắt nguồn từ một trục trặc trong các hệ thống tự động chịu trách nhiệm giám sát tình trạng máy chủ. Theo Microsoft, một thành phần có nhiệm vụ xác minh trạng thái của các máy chủ đã bắt đầu hoạt động sai chức năng, châm ngòi cho một hiệu ứng dây chuyền khiến các máy chủ vẫn hoạt động tốt bị gắn cờ nhầm là không phản hồi. Điều này tạo ra một "nút thắt cổ chai phục hồi", nơi hạ tầng phải vật lộn để xử lý tải khi các hệ thống bị ngắt kết nối để can thiệp thủ công. Sự trớ trêu ở đây thật rõ ràng: chính các công cụ được thiết kế để đảm bảo tính sẵn sàng cao và khả năng phục hồi tự động lại là tác nhân gây ra sự sụp đổ.
Sự cố này đặc biệt nhạy cảm khi đặt trong bối cảnh lịch sử gần đây của các gián đoạn CNTT quy mô lớn. Khi Bộ trưởng Nội vụ Úc Tony Burke đưa ra những so sánh với sự cố CrowdStrike năm 2024, ông đã chạm đến một nỗi lo ngại đang ngày càng lớn trong giới lãnh đạo cấp cao (C-suite): nỗi sợ về sự cố mang tính hệ thống do "bản cập nhật" gây ra. Mặc dù Microsoft đã nhanh chóng làm rõ rằng đây không phải là một cuộc tấn công mạng độc hại, nhưng tác động vận hành lại phản ánh sự hỗn loạn của một vụ vi phạm bảo mật. Khi một hệ thống thần kinh trung ương như Microsoft 365 chìm trong bóng tối, các hiệu ứng thứ cấp đối với các dịch vụ phụ thuộc—từ việc tích hợp lịch cho đến các nền tảng CRM của bên thứ ba—sẽ tạo ra một làn sóng lan truyền rất khó kiểm soát.
Những gợn sóng kinh tế và sự gián đoạn doanh nghiệp
Chi phí kinh tế của một sự cố như vậy rất khó định lượng trong thời gian thực, nhưng các tín hiệu đã bắt đầu xuất hiện trên thị trường. Cổ phiếu của Microsoft đã giảm 2,6% trong phiên giao dịch trước giờ mở cửa, phản ánh sự bất an của nhà đầu tư liên quan đến độ tin cậy của chiến lược ưu tiên đám mây (cloud-first) của công ty. Hơn thế nữa, sự gián đoạn đã buộc phải hiệu chỉnh lại các mốc thời gian của doanh nghiệp. Tập đoàn hàng xa xỉ Thụy Sĩ Richemont đã phải hoãn việc công bố lợi nhuận, và nhà sản xuất xe tải điện Workhorse Group buộc phải dời kết quả quý ba sang tuần tới. Đây không chỉ là những sự chậm trễ mang tính hành chính; chúng là những sự gián đoạn đối với tính minh bạch và thời điểm mà thị trường toàn cầu đòi hỏi.
Vượt ra ngoài phòng họp, tác động đối với các lĩnh vực hậu cần và dịch vụ là vô cùng sâu sắc. Chẳng hạn, Air India đã phải nhờ cậy đến việc định tuyến lại email thủ công để duy trì dịch vụ khách hàng, một lời nhắc nhở rõ ràng về việc các tổ chức "ưu tiên kỹ thuật số" quay trở lại các giải pháp thay thế thủ công nhanh chóng đến mức nào khi đám mây gặp sự cố. Sự cố này nêu bật một khiếm khuyết chí mạng trong mô hình kinh doanh hiện đại: giả định về tính sẵn sàng "năm con số chín" (99,999% thời gian hoạt động). Khi giả định đó bị phá vỡ, các doanh nghiệp thấy mình rơi vào cảnh không có kế hoạch dự phòng, do đã chuyển giao hạ tầng cốt lõi cho một nhà cung cấp dẫu hùng mạnh nhưng không phải là không thể sai sót.
Tính mong manh của việc tập trung hóa quy mô siêu lớn
Chúng ta hiện đang chứng kiến một giai đoạn hợp nhất mạnh mẽ trong lĩnh vực công nghệ, nơi các công cụ tích hợp AI như Microsoft Copilot đang được dệt vào chính cấu trúc của năng suất hàng ngày. Với hơn 100 triệu người dùng hoạt động hàng tháng, Copilot không còn là một tính năng thử nghiệm; nó là một lớp nền tảng của doanh nghiệp. Khi lớp này sụp đổ, tổn thất năng suất không chỉ mang tính tuyến tính—mà là theo cấp số nhân. Sự phụ thuộc vào một hệ sinh thái đơn lẻ, khổng lồ đồng nghĩa với việc một lỗi trong thành phần kiểm tra tình trạng máy chủ có thể thực sự "tạm dừng" nền kinh tế toàn cầu.
Sự tập trung hóa này là con dao hai lưỡi. Một mặt, nó mang lại hiệu quả, tính bảo mật và sự tích hợp chưa từng có. Mặt khác, nó tạo ra kịch bản "quá lớn để sụp đổ" mà các cơ quan quản lý đang ngày càng soi xét kỹ lưỡng. Khi các công ty tiếp tục di dời hệ thống cũ của họ lên đám mây, áp lực đối với các nhà cung cấp như Microsoft, Amazon Web Services và Google trong việc duy trì sự ổn định tuyệt đối ngày càng tăng. Các sự kiện của tuần này chắc chắn sẽ châm ngòi cho một làn sóng các cuộc thảo luận về "đa dạng hóa đám mây", khi các Giám đốc Công nghệ (CTO) và Giám đốc Thông tin (CIO) bắt đầu đặt câu hỏi liệu chiến lược nhà cung cấp đơn lẻ có phải là rủi ro mà họ có thể mạo hiểm duy trì trong một bối cảnh kỹ thuật số ngày càng biến động hay không.
Nhìn về phía trước: Con đường hướng tới khả năng phục hồi
Khi Microsoft tiến tới sự ổn định, trọng tâm chuyển từ việc phục hồi tức thời sang trách nhiệm giải trình lâu dài. Quyết định của công ty nhằm kéo dài cửa sổ thời gian chờ giao email thêm 48 giờ là một miếng dán vết thương cần thiết để bảo toàn tính toàn vẹn của dữ liệu, nhưng nó không giải quyết được các vấn đề kiến trúc cơ bản. Thách thức kỹ thuật bây giờ là xây dựng các cơ chế "chống lỗi" (fail-safes) để ngăn chặn các đợt kiểm tra tình trạng tự động châm ngòi cho một cuộc tấn công từ chối dịch vụ do chính mình gây ra. Việc phụ thuộc vào các hệ thống phục hồi tự động, dẫu hiệu quả, nhưng vẫn đòi hỏi sự giám sát của con người trong vòng lặp (human-in-the-loop) vốn đã thiếu sót rõ rệt trong sự cố này.
Đối với ngành công nghệ nói chung, bài học rất rõ ràng: khả năng phục hồi không chỉ là việc có các máy chủ dự phòng; mà là việc có các *quy trình* dự phòng. Khi chúng ta theo dõi quá trình phục hồi diễn ra, cộng đồng kinh doanh toàn cầu sẽ mong đợi nhiều hơn là một "miếng vá". Họ sẽ tìm kiếm một sự thay đổi cơ bản trong cách các gã khổng lồ này quản lý các bản cập nhật và sức khỏe hạ tầng. Trong kỷ nguyên mà kết nối kỹ thuật số là ô xy của nền kinh tế toàn cầu, ngành công nghệ không thể tiếp tục nín thở mỗi khi một thành phần máy chủ gặp sự cố. Kỷ nguyên đặt niềm tin mù quáng vào hạ tầng đám mây đã kết thúc; kỷ nguyên về khả năng phục hồi kỹ thuật số nghiêm ngặt, minh bạch và đa dạng hóa đã bắt đầu.
L'économie mondiale contemporaine repose sur une couche logicielle mince et invisible, à laquelle nous ne prêtons attention que lorsqu'elle s'évapore. Cette semaine, cette couche s'est fissurée. Dès jeudi après-midi, une panne généralisée au sein de l'infrastructure de Microsoft a réduit au silence le cœur battant du numérique pour des millions d'entreprises, d'agences gouvernementales et d'utilisateurs individuels. Des salles de marché londoniennes aux sièges sociaux de la région Asie-Pacifique, la soudaine indisponibilité d'Outlook, de Teams et de SharePoint a rappelé avec acuité que notre dépendance à l'égard d'une poignée de fournisseurs cloud hyperscale a créé un point de défaillance unique, aussi fragile qu'essentiel.
Tandis que les ingénieurs de Microsoft s'activaient pour diagnostiquer la cause profonde — pointant initialement du doigt une surcharge de trafic et un composant défectueux de vérification de l'état des serveurs —, les répercussions ont été immédiates et aveugles. La panne n'a pas seulement perturbé les communications internes ; elle a paralysé les rouages du commerce. À mesure que le jour se levait sur l'Europe vendredi, le silence des serveurs de messagerie s'est mué en l'indicateur assourdissant d'une vulnérabilité systémique. Pour un monde qui a émigré l'intégralité de sa pile opérationnelle dans le nuage, l'incapacité d'accéder à son espace de travail numérique ne relève plus du simple désagrément : c'est l'arrêt total de la continuité des affaires.
L'anatomie d'un effondrement dans le cloud
La genèse technique de cette panne semble résider dans une défaillance des systèmes automatisés chargés de surveiller la santé des serveurs. Selon Microsoft, un composant voué à vérifier le statut des machines s'est mis à dysfonctionner, enclenchant un effet domino où des serveurs parfaitement opérationnels ont été erronément signalés comme inactifs. Cela a généré un « goulot d'étranglement de la reprise », l'infrastructure luttant pour absorber la charge alors que les systèmes étaient mis hors ligne pour une intervention manuelle. L'ironie est palpable : les outils mêmes conçus pour garantir une haute disponibilité et une résilience automatisée ont été les catalyseurs de cet effondrement.
Cet incident revêt une sensibilité particulière au vu de l'histoire récente des perturbations informatiques à grande échelle. Lorsque le ministre australien des Affaires intérieures, Tony Burke, a établi un parallèle avec l'incident CrowdStrike de 2024, il a mis le doigt sur une angoisse croissante au sein des directions générales : la peur d'une défaillance systémique « induite par les mises à jour ». Bien que Microsoft se soit empressé de préciser qu'il ne s'agissait pas d'une cyberattaque malveillante, l'impact opérationnel rappelle le chaos d'une faille de sécurité. Lorsqu'un système nerveux central tel que Microsoft 365 s'obscurcit, les effets secondaires sur les services dépendants — allant des intégrations de calendriers aux plateformes CRM tierces — génèrent une onde de choc difficile à endiguer.
Ondes de choc économiques et perturbations corporatives
Le coût économique d'une telle panne est difficile à quantifier en temps réel, mais les signaux se lisent déjà sur les marchés. L'action Microsoft a reculé de 2,6 % lors des échanges préliminaires, traduisant l'inquiétude des investisseurs quant à la fiabilité de la stratégie cloud-first de l'entreprise. Plus concrètement, la perturbation a contraint à un réajustement des calendriers corporatifs. Le géant suisse du luxe Richemont a vu la publication de ses résultats retardée, et le fabricant de camions électriques Workhorse Group a dû repousser l'annonce de ses résultats du troisième trimestre à la semaine prochaine. Il ne s'agit pas là de simples délais administratifs, mais bien d'atteintes à la transparence et au calendrier qu'exigent les marchés mondiaux.
Au-delà de la salle du conseil, l'impact sur la logistique et les secteurs de services s'est avéré profond. Air India, par exemple, a dû recourir au réacheminement manuel de ses courriels pour maintenir son service client, rappelant brutalement avec quelle rapidité les organisations « 100 % numériques » reviennent à des solutions analogiques lorsque le cloud vacille. Cet incident met en lumière une faille critique du modèle d'entreprise moderne : le postulat d'une disponibilité à « cinq neuf » (99,999 % de temps de fonctionnement). Lorsque ce postulat est violé, les entreprises se retrouvent dénuées de plan de secours, ayant externalisé leur infrastructure fondamentale auprès d'un fournisseur qui, bien que puissant, n'est pas infaillible.
La fragilité de la centralisation hyper-échelle
Nous traversons actuellement une période de consolidation intense dans le secteur technologique, où des outils intégrés par l'intelligence artificielle, tels que Microsoft Copilot, sont tissés au cœur même de la productivité quotidienne. Avec plus de 100 millions d'utilisateurs actifs mensuels, Copilot n'est plus une fonctionnalité expérimentale ; c'est une strate fondatrice de l'entreprise. Lorsque cette couche défaille, la perte de productivité n'est pas seulement linéaire, elle est exponentielle. La dépendance à l'égard d'un écosystème unique et massif signifie qu'un simple bogue dans un composant de surveillance des serveurs peut littéralement « mettre en pause » l'économie mondiale.
Cette centralisation constitue une arme à double tranchant. D'un côté, elle offre une efficacité, une sécurité et une intégration sans égales. De l'autre, elle engendre un scénario de type « too big to fail » que les régulateurs scrutent avec de plus en plus d'attention. Alors que les entreprises continuent de migrer leurs systèmes historiques vers le nuage, la pression exercée sur des géants tels que Microsoft, Amazon Web Services et Google pour maintenir une stabilité absolue ne cesse de croître. Les événements de cette semaine déclencheront sans aucun doute une vague de discussions autour de la « diversification du cloud », les DSI et directeurs techniques commençant à s'interroger sur la viabilité d'une stratégie mono-fournisseur dans un paysage numérique de plus en plus volatil.
Perspectives : la voie de la résilience
Alors que Microsoft s'achemine vers la stabilisation, l'attention se déplace de la récupération immédiate vers la responsabilité à long terme. La décision de l'entreprise d'étendre la fenêtre de délai pour la distribution des courriels de 48 heures constitue un « pansement » nécessaire pour préserver l'intégrité des données, mais elle ne résout en rien les problèmes architecturaux sous-jacents. Le défi ingénierique consiste désormais à concevoir des mécanismes de sécurité infaillibles (« fail-safes ») qui empêchent les contrôles de santé automatisés de déclencher une attaque par déni de service auto-infligée. Le recours à des systèmes de reprise automatisés, bien qu'efficace, exige une supervision humaine qui a manifestement fait défaut lors de cet incident.
Pour l'ensemble de l'industrie technologique, la leçon est limpide : la résilience ne se résume pas à posséder des serveurs redondants, elle implique de concevoir des *processus* redondants. À mesure que la reprise progresse, la communauté des affaires mondiale attendra bien plus qu'un simple « correctif ». Elle exigera une refonte fondamentale de la manière dont ces mastodontes gèrent les mises à jour et la santé de leurs infrastructures. À une époque où la connectivité numérique est l'oxygène de l'économie mondiale, l'industrie ne peut plus se permettre de retenir son souffle à chaque défaillance d'un composant serveur. L'ère de la confiance aveugle dans l'infrastructure cloud est révolue ; celle d'une résilience numérique rigoureuse, transparente et diversifiée vient de s'ouvrir.
La economía global contemporánea se sustenta sobre una capa de software sutil e invisible que apenas advertimos hasta que desaparece. Esta semana, esa capa se ha fracturado. A partir del jueves por la tarde, un fallo generalizado en la infraestructura de Microsoft silenció de forma efectiva el pulso digital de millones de empresas, organismos públicos y usuarios particulares. Desde las mesas de contratación de Londres hasta las oficinas corporativas en la región de Asia-Pacífico, la repentina falta de disponibilidad de Outlook, Teams y SharePoint sirvió como crudo recordatorio de que nuestra dependencia de un puñado de proveedores de nube a gran escala ha generado un punto único de fallo tan frágil como indispensable.
Mientras los ingenieros de Microsoft se afanaban por diagnosticar la causa raíz —apuntando inicialmente a un repunte del tráfico y a un componente defectuoso en la verificación del estado de los servidores—, las consecuencias fueron inmediatas e indiscriminadas. La avería no se limitó a perturbar las comunicaciones internas, sino que paralizó el engranaje del comercio. Al amanecer en Europa el viernes, el silencio de los servidores de correo electrónico se convirtió en el estridente indicador de una vulnerabilidad sistémica. Para un mundo que ha trasladado todo su entramado operativo a la nube, la imposibilidad de acceder al espacio de trabajo digital ya no constituye una mera incomodidad; representa el cese total de la continuidad de negocio.
La anatomía de un colapso en la nube
El origen técnico del apagón parece hallarse en un fallo de los sistemas automatizados encargados de supervisar la salud de los servidores. Según Microsoft, un componente destinado a verificar el estado de los equipos comenzó a funcionar erróneamente, lo que desató un efecto en cadena por el cual los servidores plenamente operativos fueron catalogados de manera incorrecta como inalcanzables. Esto generó un "cuello de botella de recuperación", ya que la infraestructura experimentó serias dificultades para gestionar la carga mientras los sistemas se desconectaban para una intervención manual. La ironía resulta palpable: las mismas herramientas concebidas para garantizar una alta disponibilidad y una resiliencia automatizada constituyeron el detonante del colapso.
Este episodio cobra especial sensibilidad ante la reciente secuencia de disrupciones informáticas a gran escala. Cuando el ministro del Interior de Australia, Tony Burke, estableció comparaciones con el incidente de CrowdStrike acaecido en 2024, puso de relieve un temor cada vez más palpable en las altas esferas directivas: el miedo al fallo sistémico provocado por "actualizaciones". Si bien Microsoft se apresuró a aclarar que no se trató de un ciberataque malicioso, el impacto operativo emula el caos propio de una brecha de seguridad. Cuando un sistema nervioso central como Microsoft 365 queda fuera de servicio, los efectos secundarios sobre las prestaciones dependientes —desde las integraciones de calendarios hasta las plataformas CRM de terceros— desencadenan una onda expansiva sumamente compleja de contener.
Efectos colaterales en la economía y disrupción corporativa
El coste económico de un apagón de estas características resulta complejo de cuantificar a tiempo real, si bien los primeros indicios ya se reflejan en los mercados. Las acciones de Microsoft descendieron un 2,6% en las operaciones previas a la apertura, evidenciando la inquietud de los inversores respecto a la fiabilidad de la estrategia de la compañía orientada a la nube. En un plano más tangible, la perturbación obligó a recalibrar los calendarios corporativos. El gigante suizo del lujo Richemont retrasó la publicación de sus resultados, y el fabricante de camiones eléctricos Workhorse Group se vio en la obligación de posponer sus cuentas del tercer trimestre para la semana venidera. No nos referimos únicamente a retrasos administrativos, sino a alteraciones en la transparencia y la puntualidad que los mercados internacionales exigen imperativamente.
Más allá de los consejos de administración, la incidencia en la logística y los sectores terciarios resultó profunda. Air India, por ejemplo, tuvo que recurrir al reencaminamiento manual de correos electrónicos para preservar la atención al cliente, lo que ilustra con crudeza la rapidez con la que las organizaciones "digitales" retornan a los métodos analógicos cuando la nube flaquea. El episodio pone de manifiesto una debilidad crítica del modelo empresarial moderno: el supuesto de una disponibilidad del "99,999%" (cinco nueves). Al quebrantarse dicha premisa, las empresas descubren su carencia de planes de contingencia, tras haber delegado su infraestructura medular en un proveedor que, si bien es poderoso, no es infalible.
La fragilidad de la centralización a gran escala
Asistimos en la actualidad a un periodo de intensa concentración en el sector tecnológico, donde herramientas integradas con inteligencia artificial, como Microsoft Copilot, se entretejen en el núcleo mismo de la productividad cotidiana. Con más de 100 millones de usuarios activos al mes, Copilot ha dejado de ser un recurso experimental para consolidarse como un estrato fundamental de la empresa. Cuando este estrato falla, la pérdida de productividad no discurre de forma lineal, sino exponencial. La dependencia de un ecosistema singular y mastodóntico implica que un error en un componente de verificación de servidores puede, de manera efectiva, "poner en pausa" la economía mundial.
Esta centralización constituye un arma de doble filo. Por un lado, procura una eficiencia, seguridad e integración sin parangón. Por otro, genera un escenario de entidades "demasiado grandes para caer" sobre el cual los reguladores posan la mirada con creciente escrutinio. En la medida en que las compañías sigan migrando sus sistemas heredados hacia la nube, se incrementará la presión sobre proveedores como Microsoft, Amazon Web Services y Google para salvaguardar una estabilidad absoluta. Los acontecimientos de esta semana suscitarán sin duda una oleada de debates en torno a la "diversificación de la nube", a medida que los directores de tecnología (CTO) y de sistemas (CIO) comiencen a cuestionarse si apostar por una estrategia de proveedor único es un riesgo que pueden permitirse asumir en un panorama digital cada vez más volátil.
Mirando al futuro: el camino hacia la resiliencia
Mientras Microsoft avanza hacia la estabilización, el foco de atención se desplaza de la recuperación inmediata a la rendición de cuentas a largo plazo. La decisión de la empresa de ampliar en 48 horas el margen de tiempo para la entrega de correos electrónicos constituye un "parche" ineludible para salvaguardar la integridad de los datos, pero no resuelve los problemas arquitectónicos subyacentes. El desafío de ingeniería actual radica en erigir "mecanismos de salvaguarda" que eviten que las comprobaciones automatizadas de estado desencadenen un ataque de denegación de servicio autoinfligido. La dependencia de sistemas de recuperación automatizados, por muy eficientes que resulten, demanda una supervisión humana de la que se careció de manera evidente durante este incidente.
Para el conjunto de la industria tecnológica, la lección es diáfana: la resiliencia no se reduce a disponer de servidores redundantes; exige contar con *procesos* redundantes. A medida que observemos el desarrollo de la recuperación, la comunidad empresarial internacional exigirá algo más que un simple "arreglo". Reclamará una transformación sustancial en la forma en que estos gigantes gestionan las actualizaciones y la salubridad de sus infraestructuras. En una época en la que la conectividad digital es el oxígeno de la economía global, el sector ya no puede permitirse contener la respiración cada vez que un componente del servidor desfallece. El tiempo de la fe ciega en la infraestructura en la nube ha concluido; ha dado comienzo la era de una resiliencia digital rigurosa, transparente y diversificada.
现代全球经济运行在极其薄弱且隐形的软件层之上,我们往往对其视而不见,直到它突然消失。本周,这一层级出现了断裂。从周四下午开始,微软基础设施内部的大规模故障有效地切断了数百万企业、政府机构和个人用户的数字心跳。从伦敦的交易大厅到亚太地区的办公楼,Outlook、Teams 和 SharePoint 的突然瘫痪,严酷地提醒着我们:对少数几家超大规模云服务商的依赖,已经创造了一个既脆弱又不可或缺的单点故障源。
当微软工程师竭力排查根本原因时——最初指向流量激增和服务器健康检查组件故障——其后果已是即时且无差别的。此次宕机不仅扰乱了内部沟通,更直接阻断了商业机器的运转。周五清晨,当欧洲迎来黎明,电子邮件服务器的沉寂成为了系统性漏洞震耳欲聋的注脚。对于一个已将整个运营堆栈迁移至云端的现代世界而言,无法访问数字工作空间不再仅仅是轻微的不便,而是业务连续性的彻底中断。
云端崩溃的解剖学
此次宕机的技术起源似乎在于负责监控服务器健康状况的自动化系统失灵。据微软称,一个负责验证服务器状态的组件开始出现故障,触发了连锁反应,导致健康的服务器被错误地标记为无响应。这造成了“恢复瓶颈”,当系统因手动干预而下线时,基础设施难以处理随之而来的负载。讽刺的是,那些旨在确保高可用性和自动化韧性的工具,竟成了导致崩溃的催化剂。
鉴于近期大型 IT 故障频发,此次事件显得尤为敏感。当澳大利亚内政部长托尼·伯克(Tony Burke)将其与 2024 年的 CrowdStrike 事件进行比较时,他触及了企业高管层日益增长的焦虑:对“更新诱发”系统性故障的恐惧。虽然微软迅速澄清这并非恶意网络攻击,但其运营影响与安全漏洞造成的混乱如出一辙。当微软 365 这样的中枢神经系统陷入黑暗,其对依赖性服务(从日历集成到第三方 CRM 平台)的连锁影响,形成了难以遏制的涟漪效应。
经济涟漪与企业中断
此类宕机的经济成本难以实时量化,但市场信号已然显现。微软股价在盘前交易中下跌 2.6%,反映出投资者对其“云优先”战略可靠性的不安。更具体地说,此次中断迫使企业时间表进行了重新校准。瑞士奢侈品巨头历峰集团(Richemont)推迟了财报发布,电动卡车制造商 Workhorse Group 也被迫将第三季度业绩发布推迟至下周。这些不仅仅是行政上的延误,更是对全球市场所要求的透明度和时效性的破坏。
在董事会之外,物流和服务业受到的冲击同样深远。例如,印度航空(Air India)不得不求助于手动重定向电子邮件以维持客户服务,这严酷地提醒人们,“数字优先”的组织在云端失效时,回归模拟备份方案的速度是何等缓慢。此次事件凸显了现代商业模式的一个关键缺陷:对“五个九”(99.999%)可用性的盲目假设。当这一假设被打破,企业发现自己陷入了缺乏应急预案的境地,因为它们已将核心基础设施外包给了一个虽然强大但并非万无一失的供应商。
超大规模集中的脆弱性
我们目前正处于科技行业深度整合的时期,像 Microsoft Copilot 这样集成 AI 的工具正被编织进日常生产力的肌理之中。Copilot 拥有超过 1 亿的月活跃用户,它已不再是一个实验性功能,而是企业的基石。当这一层级失效时,生产力的损失不仅是线性的,更是指数级的。对单一庞大生态系统的依赖意味着,一个服务器健康检查组件中的漏洞,就能有效地让全球经济“暂停”。
这种集中化是一把双刃剑。一方面,它提供了无与伦比的效率、安全性和集成度;另一方面,它创造了一个监管机构日益关注的“大而不能倒”的局面。随着企业继续将遗留系统迁移到云端,微软、亚马逊云科技(AWS)和谷歌等供应商维持绝对稳定性的压力与日俱增。本周的事件无疑将引发一波关于“云多元化”的讨论,首席技术官(CTO)和首席信息官(CIO)们开始质疑,在日益动荡的数字环境中,单一供应商战略是否是一项他们负担得起的风险。
展望未来:通往韧性之路
随着微软迈向稳定,焦点从即时恢复转向了长期问责。该公司决定将电子邮件投递的超时窗口延长 48 小时,这是一种保护数据完整性的必要“创可贴”,但并未解决潜在的架构问题。现在的工程挑战在于构建“故障安全”机制,防止自动化健康检查触发自残式的拒绝服务攻击。对自动化恢复系统的依赖虽然高效,但显然缺乏此次事件中亟需的“人在回路”监督。
对于更广泛的科技行业而言,教训显而易见:韧性不仅仅在于拥有冗余服务器,更在于拥有冗余的“流程”。随着恢复工作的推进,全球商业界期待的不仅仅是一个“修复方案”,而是这些科技巨头在管理更新和基础设施健康方式上的根本性变革。在一个数字连接即全球经济氧气的时代,当服务器组件发生故障时,行业已无法再承受屏住呼吸的代价。对云基础设施盲目信任的时代已经结束;一个严谨、透明且多元化的数字韧性时代已经开启。
Editorial Standards & Multi-Language Synthesis: This dispatch was synthesized and fact-checked by the ParisDaily Editorial Desk across 5 global editions (EN, FR, VI, ES, ZH), cross-referencing primary international wire reports and real-time search intelligence.